En tant qu'entreprises, nous collectons et générons une quantité considérable de données. Pour avoir une idée précise de la quantité d'informations générées en 2024, 149 zettaoctets (soit 149 suivi de 21 zéros). Ce nombre devrait atteindre 394 zettaoctets d'ici 2028.
Une grande partie de cela est informations sensibles, et, en tant que tel, doit être protégé contre accès non autorisé en utilisant une stratégie robuste de protection des données. Certaines peuvent être mises de côté. le contrôle d'accès basé sur les rôles (RBAC) et l'authentification multifacteur (AMF). Cependant, certains cas d'utilisation nécessitent de partager certaines données personnelles avec d'autres, tout en en conservant une partie afin de limiter les risques d'exposition.
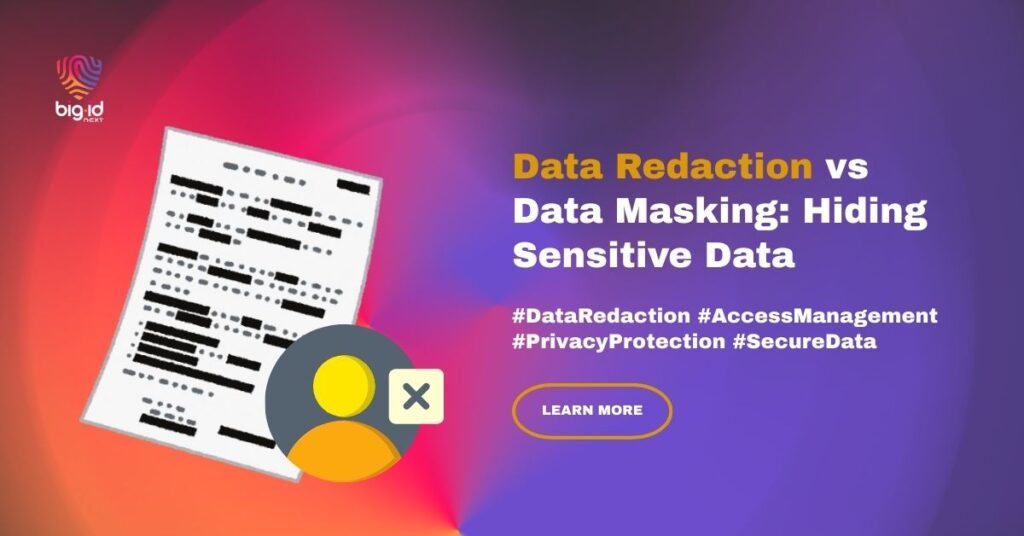
Dans ce cas, la dissimulation des données va au-delà de la simple dissimulation visuelle ; elle joue un rôle crucial dans la sécurité des données et le respect de la vie privée. Dans ce contexte, il est également important de comprendre la distinction entre rédaction de données vs masquage de données, car chacun sert des objectifs de sécurité et de conformité différents.
Qu'est-ce que la rédaction de données ?
Vous avez peut-être vu des films et des documentaires où, par exemple, la CIA a publié un document, mais dont certaines parties ont été censurées. rédaction de données.
Il s'agit d'une pratique de sécurité des données consistant à cacher ou à retenir de manière permanente des données personnelles identifiables, médicales, confidentielles ou informations personnelles sensibles. Lorsque vous le faites sur papier, le document peut être partagé avec des personnes qui ont besoin de voir une partie du contenu, mais pas la totalité.
Une fois réalisée numériquement, elle peut être personnalisée en fonction du rôle et des besoins de chaque personne. Par exemple, vous pourriez vouloir communiquer l'adresse e-mail d'un client à un membre du service marketing, mais pas ses coordonnées bancaires. L'expédition des produits, quant à elle, n'a pas besoin de ces informations, mais l'adresse du domicile peut être nécessaire pour expédier les produits, tout en garantissant leur sécurité. pratiques de gestion des données sont suivis.
Une rédaction efficace des données est utilisée dans ces scénarios pour protéger le contenu sensible sans compromettre l'efficacité opérationnelle ou l'accès aux données non sensibles.
La rédaction de données consiste à identifier et à éliminer le contenu sensible de manière à garantir la confidentialité tout en préservant l'utilisabilité des documents, le cas échéant. Elle peut également s'avérer utile lors du partage d'informations avec les tiersPar exemple, vous souhaiterez peut-être masquer votre adresse IP lors du partage des journaux réseau afin de protéger les détails de votre infrastructure.
Rédaction statique ou dynamique
Comme nous l'avons vu, la rédaction concerne toutes les données non destinées à être partagées. La méthode utilisée varie selon que vous la réalisez sur papier, manuellement sur un document numérique ou de manière automatisée.
On paper, redaction is often just using a black marker over anything you want to obscure. Digital formats like PDFs also allow you to highlight over the text, although that’s proven to be ineffective more than once. However, it is possible to hide information in such documents using the “Redact” tool.
Of course, these are manual methods. If you’re an enterprise working with vast quantities of data, you would need to automate the process, because doing it manually is just not viable. There are several software programs and platforms that can automate redaction, including BigID. Simply provide the rules, and the tool will implement your data redaction policy. These redaction tools are being used across industries to streamline compliance and enhance security.
Rédaction de données statiques
La caviardage statique est une approche prédéfinie et basée sur des règles pour protéger les informations sensibles. Dans ce cas, les informations sensibles sont définitivement supprimées ou masquées dans une version fixe des données, au moment de leur exportation ou de la préparation du document. La caviardage est irréversible. Une fois caviardées, les données sont altérées et ne peuvent être restaurées. Cette méthode est généralement utilisée pour les documents ou rapports partagés en externe afin de sécuriser le partage des données.
Rédaction dynamique des données
La rédaction dynamique s'effectue en temps réel, appliquant une logique de rédaction lors de l'accès aux données, en fonction des rôles des utilisateurs ou des règles contextuelles. Les données d'origine restent inchangées dans le stockage. Cependant, elles apparaissent expurgées aux utilisateurs non autorisés. Cette approche est couramment utilisée dans les applications ou les tableaux de bord où il est nécessaire de masquer conditionnellement des informations sensibles en fonction des autorisations de l'utilisateur.
Rédaction et masquage des données : les deux méthodes de confidentialité des données
La suppression et le masquage des données sont des méthodes visant à protéger les informations sensibles contre les personnes non autorisées à y avoir accès. Leur mise en œuvre est toutefois légèrement différente.
Comme nous l'avons vu, la rédaction des données masque complètement l'information. Elle « occulte » tout ce que le lecteur ne devrait pas être autorisé à voir, y compris le format et la longueur.
Le masquage des données, quant à lui, remplace l'information par une autre information. Par exemple, chaque caractère est remplacé par un astérisque ou un X. Les données masquées conservent leur format ou leur structure, ce qui les rend utiles lorsque les données doivent rester fonctionnelles ou réalistes, sans pour autant être divulguées, soutenant ainsi une stratégie globale de confidentialité des données. Alors que le chiffrement transforme les données en un format illisible nécessitant une clé pour les décoder, le masquage masque les valeurs réelles de manière à préserver leur utilisation. Avec la suppression des données, l'autre partie ne peut rien voir, tandis que le masquage masque les valeurs réelles.
La différence entre le masquage et la rédaction des données réside dans la préservation du format, par opposition à leur dissimulation complète. Le masquage est idéal lorsque vous souhaitez que les informations soient fonctionnelles et conservent leur forme, mais que vous ne souhaitiez pas qu'elles soient visibles, réduisant ainsi le risque de violation de données. Il peut être utilisé pour partager des informations avec des développeurs, des testeurs et des analystes qui en ont besoin, mais pas nécessairement. informations personnelles identifiables (PII).
La rédaction, en revanche, est plus appropriée lorsqu'un détail, notamment la longueur ou le format, pourrait exposer des informations sensibles. Elle offre un niveau de protection plus élevé en supprimant même les indices contextuels.
Par exemple, s'il s'agit d'un numéro de carte de crédit, tout le monde sait qu'il comporte 16 chiffres. Vous pouvez masquer chaque chiffre individuellement, mais peu importe que les gens puissent voir sa longueur. En revanche, s'il s'agit d'un diagnostic médical, même la simple vue d'une partie du mot ou de sa longueur pourrait permettre à quelqu'un de le deviner.
Quand expurger des données et quels types de données expurger
Vous devez rédiger des données sensibles, qui sont généralement protégées par les lois sur la confidentialité des données, mais vous avez également une responsabilité éthique envers vos clients.
Bien sûr, cela est pertinent par rapport à ce que vous avez collecté auprès d'eux ; il y a aussi vos informations commerciales sensibles.
Voici une liste des types de données que vous souhaiterez peut-être rédiger :
- Informations personnelles identifiables : Il s'agit de tout élément permettant d'identifier la personne à laquelle il appartient, que ce soit seul ou en le combinant avec d'autres données. Par exemple, le numéro de sécurité sociale (SSN), le numéro de passeport, le nom complet (combiné à d'autres informations), etc.
- Informations médicales protégées : Les PHI sont des informations médicales protégées par la Loi sur la portabilité et la responsabilité en matière d'assurance maladie (HIPAA). Il comprend les numéros de dossiers médicaux, les numéros de bénéficiaires du régime d'assurance maladie, les diagnostics médicaux, les traitements et les conditions, etc.
- Informations financières : Ce type d’informations comprend les numéros de carte de crédit ou de débit, les coordonnées bancaires, les informations sur les salaires ou les rémunérations, ou les numéros d’identification fiscale.
- Informations juridiques ou gouvernementales : Les noms des témoins ou des victimes d’un crime, les informations sur les mineurs, l’identité des agents des forces de l’ordre et les témoignages sensibles peuvent être des informations qui doivent être protégées.
- Informations pédagogiques et de recherche : Toutes les données qu'un établissement d'enseignement collecte sur un étudiant sont couvertes par la Loi sur les droits à l'éducation et à la vie privée de la famille (FERPA), mais des informations telles que les identifiants des sujets de recherche et les données expérimentales liées à un individu sont également des informations sensibles et doivent être expurgées.
- Informations commerciales sensibles : Vous ne voudriez pas révéler des secrets commerciaux, des formules ou des algorithmes exclusifs, des communications internes ou des termes de contrats, que vous souhaiterez peut-être également rédiger.
- Informations classifiées : Dans les secteurs gouvernementaux, militaires ou réglementés, la protection des informations classifiées est un cas d’utilisation non négociable de la rédaction.
Comment utiliser la rédaction de données : techniques de protection des données
Une stratégie moderne de rédaction de données comprend le masquage, l'obfuscation et l'anonymisation des données. Certaines de ces techniques peuvent donc appartenir à d'autres catégories. Elles restent néanmoins utiles pour vous aider à respecter les réglementations sur la confidentialité des données, telles que la Règlement général sur la protection des données (RGPD), Loi californienne sur la protection des consommateurs (CCPA)ou HIPAA.
- Rédaction de black-out : Dissimule visuellement les informations sensibles en superposant des cases noires ou des remplissages pleins dans les documents, couramment utilisés dans les dossiers juridiques et gouvernementaux.
- Whiteout ou suppression de contenu : Efface le contenu sensible en le remplaçant par un espace vide, éliminant ainsi la visibilité sans perturber la mise en page environnante, ce qui est essentiel pour maintenir l'intégrité des données privées.
- Correspondance et remplacement de motifs : Utilise des expressions régulières ou la détection de modèles pour identifier les informations sensibles et les remplacer par un texte d'espace réservé tel que « SUPPRIMÉ ».
- Substitution de caractères : Remplace les caractères des données sensibles par des symboles (par exemple, des astérisques) tout en préservant un certain contexte, comme l'affichage uniquement des quatre derniers chiffres d'un numéro de carte de crédit.
- Tokenisation des données : Convertit les valeurs sensibles en jetons aléatoires qui n'ont aucune signification sans un système de mappage sécurisé, masquant ainsi efficacement les données d'origine.
- Mélange : Anonymise les données en réorganisant les valeurs au sein d'un ensemble de données tout en conservant la structure, couramment utilisé dans les environnements de test ou d'analyse.
- Annulation : Supprime les informations sensibles en les remplaçant par des valeurs nulles ou vides, les effaçant ainsi efficacement de l'ensemble de données.
- Généralisation: Remplace des données spécifiques par des catégories plus larges pour réduire l'identifiabilité, par exemple en modifiant les dates de naissance exactes en tranches d'âge.
- Agrégation: Résume les données sensibles en totaux ou en informations au niveau du groupe, minimisant ainsi le risque d'identification des individus et protégeant les informations sensibles ou personnellement identifiables.
- Pseudonymisation : Remplace les détails d'identification par des pseudonymes cohérents ou des identifiants artificiels, préservant ainsi la convivialité des données tout en protégeant les identités.
- Rédaction de la reconnaissance d'entité nommée (NER) : Effets de levier AI et le traitement du langage naturel pour identifier et rédiger automatiquement les noms, les dates et d’autres entités dans un texte non structuré.
- Rédaction basée sur des règles ou contextuelle : Utilise des règles personnalisées ou une logique métier pour rédiger des données en fonction du type de contenu, du niveau de sensibilité ou de l'accès des utilisateurs.
- Rédaction des métadonnées : Supprime les métadonnées cachées telles que les noms d'auteur, les révisions de documents et les commentaires pour éviter les fuites de données involontaires.
- Rédaction au niveau du champ de la base de données : Rédige ou masque des champs spécifiques dans les bases de données en fonction des rôles des utilisateurs ou des politiques d'accès, souvent en temps réel.
- Rédaction imprimée : Applique la rédaction aux documents imprimés, souvent par le biais d'une révision manuelle et d'une rédaction physique avant la numérisation ou l'archivage.
Chaque technique joue un rôle pour garantir que les données sensibles restent protégées tout en permettant l’accès ou l’analyse nécessaire.
Cas d'utilisation de la rédaction de données
Votre politique de rédaction de données peut être utilisée aux fins suivantes :
- Conformité aux réglementations sur la confidentialité des données
- Sécurisation des informations sensibles des clients
- Protéger les données internes de votre entreprise
Appliquer la sécurité des données avec BigID
La plateforme BigID offre une solution complète pour protéger les données sensibles détenues et stockées par votre entreprise. Elle offre non seulement de nombreuses options de masquage et de suppression des données d'entreprise, mais aussi des fonctionnalités de découverte et de cartographie des données.
Pour découvrir toutes les façons dont cette plateforme peut vous aider dans la sécurité et la gouvernance de vos données, planifiez une démo aujourd'hui !
Frequently Asked Questions About Data Redaction
What Is Static Data Redaction?
Static data redaction permanently removes or obscures sensitive information in a fixed copy of a document or dataset. It is typically applied when data is prepared or exported for external sharing. The redaction is irreversible, meaning the protected information cannot be recovered from the redacted version.
What Is Dynamic Data Redaction?
Dynamic data redaction hides sensitive information in real time according to the viewer’s role, permissions, or context. The original data remains unchanged in storage, but unauthorized users see a redacted version. It is commonly used in applications, databases, and dashboards where different users require different levels of access.
What Is the Difference Between Data Redaction and Data Masking?
Data redaction completely conceals or removes sensitive information, including clues about its content or length. Data masking replaces the original value with altered characters, tokens, or realistic substitute data while preserving its structure. Redaction is suited to secure sharing, while masking helps keep protected data usable for purposes such as testing and analysis.
Can Redacted Data Be Recovered?
Properly applied static redaction is permanent and cannot be reversed within the redacted document or dataset. Simply covering text visually, however, may leave the underlying information accessible. Organizations should use dedicated redaction tools that remove the sensitive content rather than relying on highlights, shapes, or formatting to conceal it.
How Can BigID Support Data Redaction?
BigID helps organizations discover, classify, and map sensitive data across their environments. Its enterprise data redaction and masking capabilities enable businesses to apply data protection policies more consistently, reduce unnecessary exposure, and support compliance when sensitive information must be accessed, processed, or shared.
Auteur